

 Digital Analytics Expert
 HTML, CSS & JS Lover
 Apps Script Developer
 Problem-Solving Oriented


Nelle ultime settimane chi segue i rank tracker l’avrà notato: i dati non tornano. Siti che spariscono dalla top 10 per un giorno e poi ricompaiono. Tool diversi che raccontano storie diverse sulla stessa keyword. Clienti che chiedono spiegazioni su crolli che, guardando Search Console, non sono mai avvenuti.
All’inizio ho pensato al solito rumore. Poi ho letto i dati.
Lo studio di Nozzle
Il 10 ottobre Nozzle, una piattaforma di SERP tracking, ha pubblicato uno studio intitolato “Poisoned Google SERPs”. La tesi è semplice e un po’ inquietante: da settembre Google risponde a una parte delle richieste dei rank tracker con pagine di risultati complete, dall’aspetto del tutto normale, ma con i risultati sostituiti.
Il campione non è piccolo. Parliamo di 27,5 milioni di SERP, più di 660 mila keyword, 49 paesi, raccolte tra il 20 agosto e il 9 ottobre.
Qualche numero:
- dal 13 settembre l’8% delle SERP è risultato “avvelenato”, contro lo 0,17% del periodo precedente
- tra il 27 e il 29 settembre si è arrivati a circa un quarto del totale
- nelle SERP avvelenate i risultati organici conservano il 20,7% dei siti della SERP precedente, contro l’88,5% di prima
- il sito monitorato da un progetto finisce fuori dalla top 10 nel 58,6% dei casi, contro il 2,7% normale
Il dettaglio che mi ha colpito di più è che la pagina non ha nulla di strano. Niente errori, niente captcha, stesso template. Nozzle ha anche verificato che è la stessa build del frontend di Google. L’unico modo per accorgersene è confrontare il risultato con lo storico della keyword.
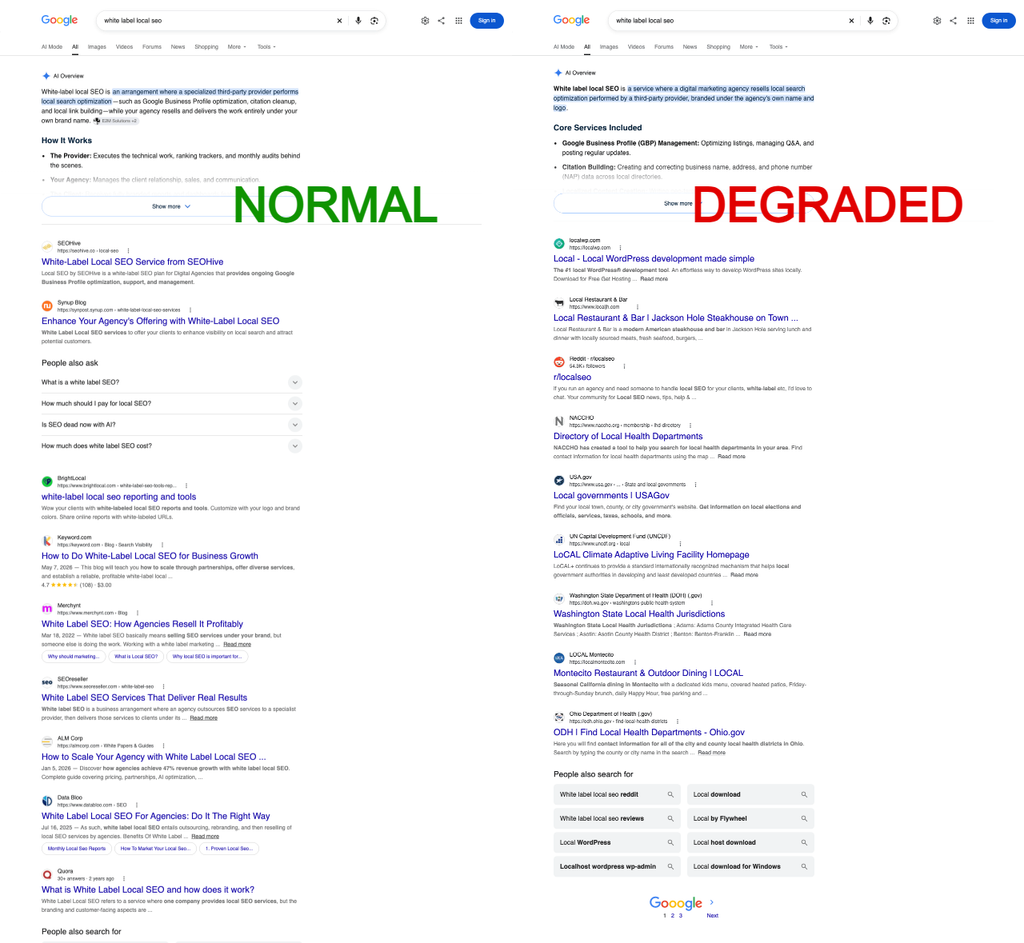
Uno degli esempi nello studio rende bene l’idea. Una ricerca su servizi SEO white label, fatta il 4 ottobre, restituisce fornitori di SEO white label. Tre giorni dopo, la stessa query restituisce un tool per WordPress, una steakhouse nel Wyoming, un elenco di dipartimenti sanitari e USA.gov. Nove siti su nove spariti dalla prima pagina.
Non è spazzatura, quindi. Sono siti veri. Solo che non c’entrano niente.
Non è solo Nozzle
Su questo voglio essere preciso, perché in giro molti articoli riprendono gli stessi numeri di Nozzle senza aggiungere nulla. E Nozzle vende dati SERP: ha tutto l’interesse a spiegare i propri dati sballati con una causa esterna.
Per fortuna c’è almeno un altro paio di riscontri fatti su dati propri.
DemandSphere, un’altra società di dati di ricerca, ci era arrivata prima. Il 1° ottobre la sua pagina di stato avvisava i clienti dei primi segnali di risultati spuri. Il 7 ottobre il fondatore Ray Grieselhuber ha pubblicato un post, Spurious data in Google SERPs, in cui stima il fenomeno a circa l’11% delle SERP raccolte ogni giorno. Precisa anche che la cifra non è definitiva e può cambiare in fretta. Un limite c’è: DemandSphere non spiega come classifica una SERP “spuria”. L’8% di Nozzle e l’11% di DemandSphere sono quindi due stime fatte in modi diversi, non due misure della stessa cosa. Però vanno nella stessa direzione.
TrueRanker ha pubblicato il 13 ottobre un’analisi sul proprio blog con un dato più recente di quello di Nozzle. Secondo loro il fenomeno non è finito, ha solo cambiato forma: al 13 ottobre i risultati che non corrispondono compaiono da pagina 2 in poi, su circa il 30% delle SERP della loro raccolta.
Poi ci sono i segnali più sparsi. Search Engine Roundtable elenca diversi fornitori che nello stesso periodo hanno comunicato problemi: Sistrix, DataForSEO, SE Ranking, Advanced Web Ranking, Morningscore. Glenn Gabe ha mostrato casi concreti in cui Ahrefs, Semrush e Sistrix raccontavano tre andamenti diversi per lo stesso sito, uno colpito dallo spam update e confermato dal proprietario.
Qui però serve cautela. Non tutti questi problemi sono avvelenamento. Advanced Web Ranking, per esempio, spiega il proprio caso con un’altra modifica di Google: i link dei risultati avvolti in un redirect google.com/goto, che alcuni tracker non riuscivano a leggere. È un problema reale ma diverso, e più facile da risolvere. Lo stesso Barry Schwartz fa notare che alcuni tool hanno confuso le due cose.
Blocco, poi veleno
La sequenza temporale è la parte più interessante. Secondo Nozzle, il 13 settembre le richieste a Google hanno cominciato a fallire in massa. Dal 20 settembre quelle che riuscivano a passare tornavano avvelenate.
Derek Perkins di Nozzle, parlando con Schwartz, ha descritto un approccio a tre livelli:
- blocco degli IP su larga scala, mirato alle grandi reti di proxy residenziali
- un forte aumento dei captcha
- l’iniezione di dati sbagliati nelle SERP considerate sospette
Ed è il terzo punto che cambia tutto.
Perché un dato falso è peggio di un dato mancante
Un blocco si vede. Ricevi un errore, il sistema lo registra come fallimento e riprova più tardi. Nel peggiore dei casi hai un buco nei dati, ma sai che c’è.
Una SERP avvelenata invece supera ogni controllo. Viene salvata come buona, finisce nel database, poi nel report, poi magari in una presentazione al cliente o in un dataset che alimenta un modello. E nessuno se ne accorge, perché dal punto di vista tecnico è andato tutto bene.
Faccio questo lavoro da abbastanza tempo per sapere che un dato mancante è un fastidio. Un dato sbagliato che sembra giusto è un problema serio. Perché ci costruisci sopra decisioni.
Chi prende il posto dei siti spariti
Nelle SERP avvelenate guadagnano spazio Reddit, Facebook, LinkedIn, Instagram e Quora. Ne perdono YouTube, Yelp e MapQuest.
C’è anche un dettaglio che non so bene come interpretare, e quindi mi limito a segnalarlo. Le parti della pagina a pagamento restano stabili. Lo shopping conserva il 92,2% degli elementi contro il 92,8% normale, e gli annunci addirittura di più: 83,7% contro 70,6%. Gli organici invece vengono stravolti. Ognuno tragga le sue conclusioni.
E in Italia?
Siamo tra i paesi meno colpiti. Secondo Nozzle l’Italia è al 3,9%, come buona parte dell’Europa occidentale. Il Regno Unito è al 3%, mentre Austria e Sudafrica superano il 18%.
Basso, quindi. Ma non zero. E con un fenomeno che cambia forma di settimana in settimana, non darei per scontato che resti così.
Cosa sappiamo e cosa no
Prima di arrivare alle conclusioni, una distinzione che secondo me va fatta.
Quello che è documentato: almeno due fornitori, con dati propri, osservano SERP complete e apparentemente normali con risultati diversi da quelli attesi, in percentuali tra l’8% e l’11%, a partire da fine settembre. Un terzo dice che il fenomeno è ancora in corso.
Quello che è un’interpretazione: che Google lo faccia apposta, e che lo faccia per contrastare lo scraping a scopo AI. Nozzle, DemandSphere e Schwartz la pensano tutti così. La lettura è plausibile, anche alla luce dello scontro legale con SerpApi. Google aveva fatto causa a SerpApi per scraping, e a luglio la giudice l’ha archiviata, stabilendo tra l’altro che i semplici risultati di ricerca non sono opere protette da copyright. Google ad agosto ha ripresentato la causa puntando sui contenuti in licenza, e SerpApi ha chiesto di nuovo l’archiviazione. Se la strada legale è in salita, quella tecnica diventa più attraente. Ma questo è un ragionamento, non una prova: Google, per quanto ho trovato, non ha commentato.
E manca ancora un test davvero neutrale. Tutte le fonti con dati originali sono aziende che vendono dati SERP. Non vuol dire che sbaglino, ma è giusto saperlo.
Cosa fare, in pratica
Se lavori con i rank tracker, qualche accorgimento:
- Non reagire ai crolli di un giorno. Secondo Nozzle il 77,9% delle SERP avvelenate torna normale entro tre giorni. Un calo vero resta.
- Confronta con lo storico, non con ieri. Anche ieri poteva essere avvelenato. Meglio guardare quali siti compaiono di solito per quella keyword nelle settimane precedenti.
- Usa Search Console come controprova. Se un sito “sparisce” dal tracker ma Search Console mostra ancora impression e click, al sito non è successo niente.
- Chiedi al tuo fornitore come sta gestendo la cosa. Alcuni hanno già comunicato qualcosa, DemandSphere sta aggiungendo metriche sul tasso di risultati spuri, altri tacciono. Anche il silenzio è un’informazione.
Per chiudere
Abbiamo trattato per anni i dati dei rank tracker come una fotografia della SERP. Non lo erano del tutto nemmeno prima, tra personalizzazione, località e device. Ma il margine di errore era rumore. Adesso può essere introdotto da Google, e senza lasciare tracce sulla pagina.
E il problema non riguarda solo chi fa SEO. Chiunque stia costruendo prodotti, report o modelli AI su dati di SERP raccolti con scraping dovrebbe farsi una domanda scomoda: quanta parte di quello che sto leggendo è vera?
Fonti
- Nozzle, Poisoned Google SERPs (10 ottobre 2026)
- DemandSphere, Spurious data in Google SERPs (7 ottobre 2026)
- DemandSphere, pagina di stato (aggiornamento del 1° ottobre 2026)
- TrueRanker, Google is feeding rank trackers the wrong SERPs (13 ottobre 2026)
- Search Engine Roundtable, Third-Party Google Rank Tracking Struggling Now (12 ottobre 2026)
- Advanced Web Ranking, How AWR adapts to Google goto URLs
- Search Engine Roundtable, Google Lawsuit Against SerpApi Dismissed (22 luglio 2026)
- Search Engine Roundtable, Google Amends Lawsuit Against SerpApi Over Licensed Content (12 agosto 2026)
- SerpApi, Google tried again. We’re moving to dismiss their claims a second time (25 agosto 2026)
Commenti recenti